おばんです。
RTX pro 2000 BlackwellとNvidia A2のベンチマークを取ってみた。とても面白いなぁ。
注意:あくまでも個人の結果ですので、細かいところの爪が甘いのはご容赦を。
<結論>
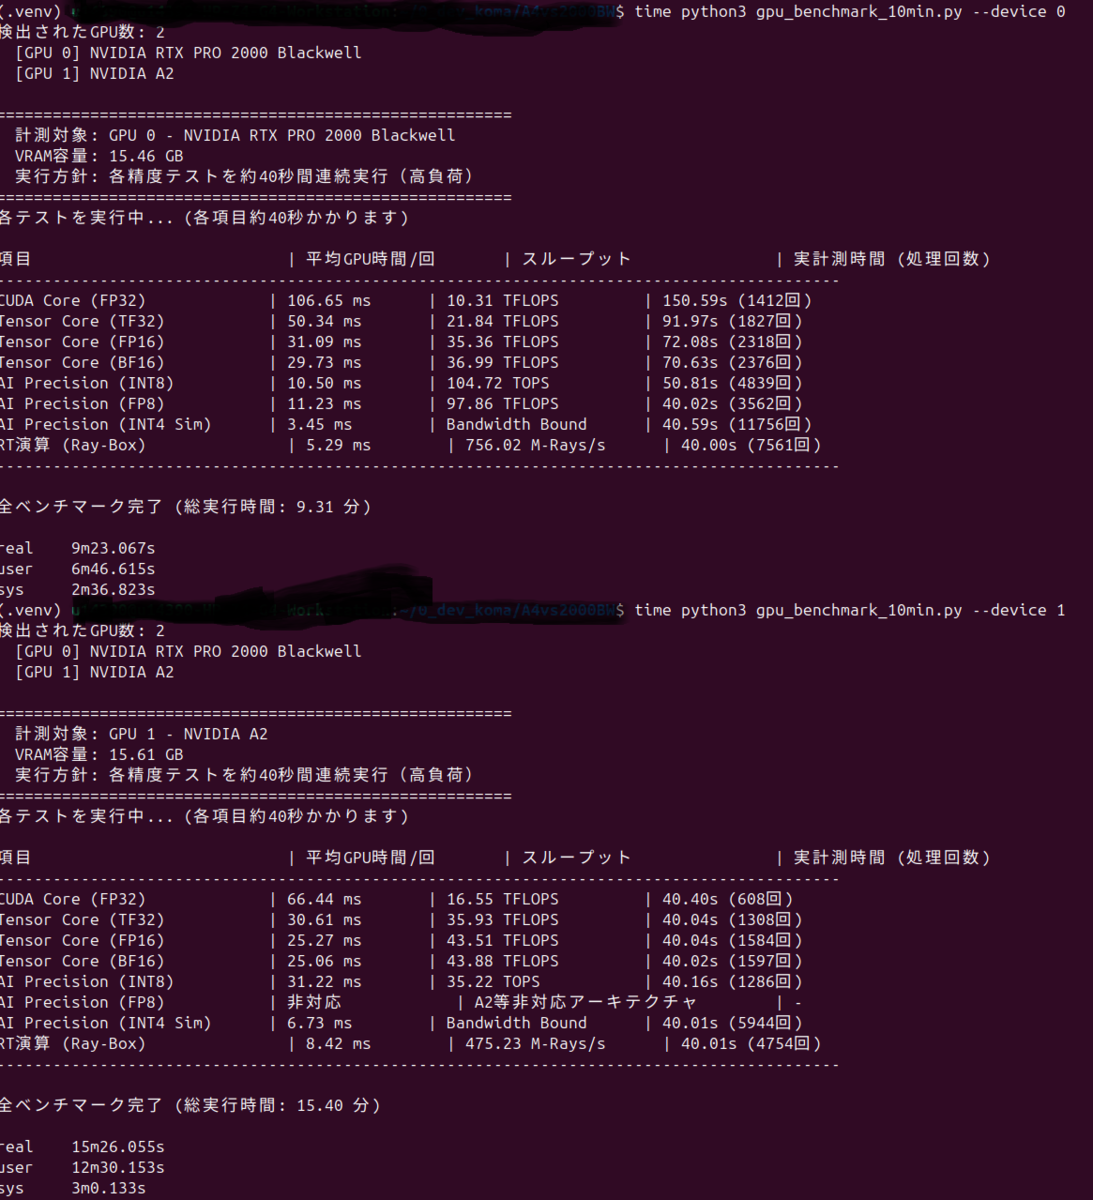
○Blackwellはとても優秀だけど、一部弱点有。
○A2のFP32の値が公称能力の約4倍。逆に2000BWのFP32の値は公称能力よりも低い結果。(A2は2ndキャッシュからあふれる計算量は遅くなる?。)
○どうもTetsa系は温度が冷却次第で性能が大きく変化(上昇)する。
○75wのgpuはやはり良いねー750W電源でも余裕の動作。熱いけど、熱くない。
<PCスペック>
PC: Hp Z4 G4
CPU:W-2235 6core 12thread
RAM:128GB
SSD:2TB
Slot1: Nvidia A2+60mm fan
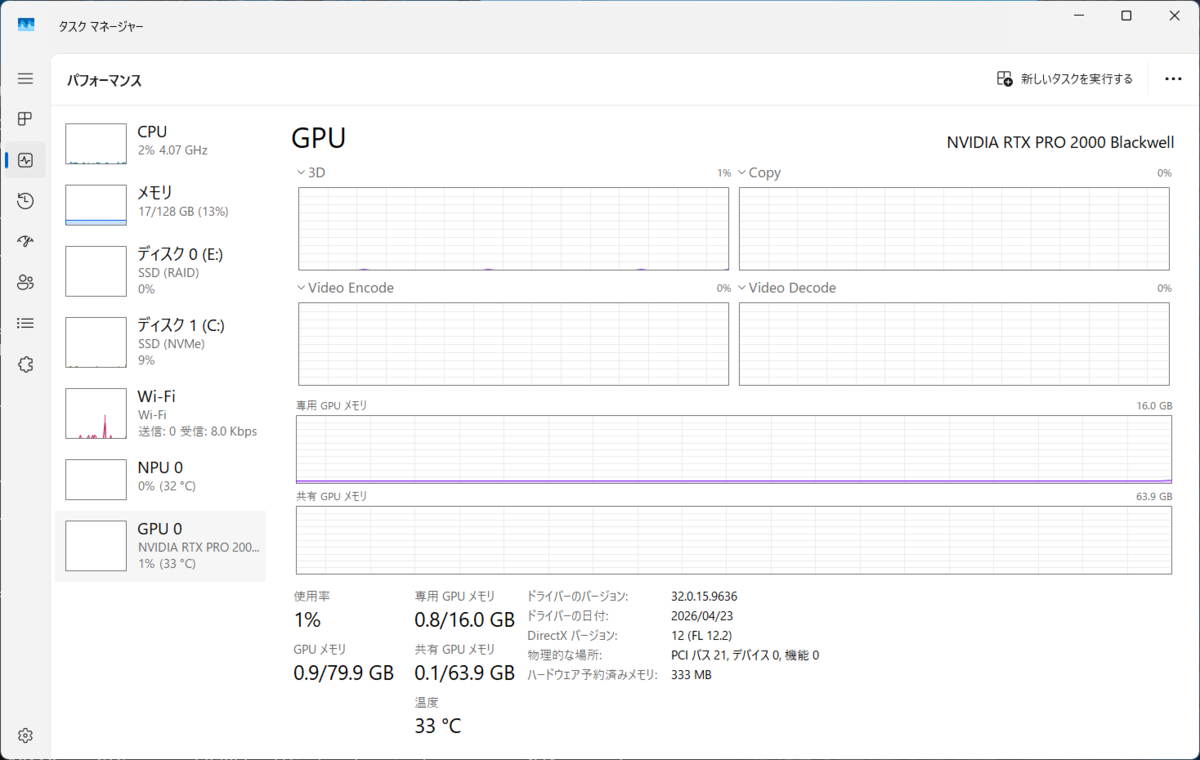
Slot3:Rtx Pro 2000 Blackwell
<ベンチマーク用スクリプト>
○gemini pro君たちに書いてもらいました。
○CUDA:13.2用pytorch
○Venv環境で実施
○計測内容等
-
マルチ精度演算の性能計測: CUDA CoreおよびTensor Coreを利用した各種精度(FP32, TF32, FP16, INT8)の演算速度を測定
-
リアルタイム監視: 演算実行中のGPU最高温度(℃)と平均消費電力(W)をバックグラウンドスレッドで自動記録
-
適応型動的バッチ処理: 事前に短いウォームアップを行い、指定したテスト時間(デフォルト5秒)に合わせて実行回数とバッチサイズを自動調整
-
正確なCUDA同期処理:
torch.cuda.Eventとsynchronize()を使用し、非同期処理による誤差を排除した正確な時間を計測
<計測項目>
| 測定項目 | 計算内容 | 出力単位 | 主な利用用途・ターゲット |
| CUDA Core (FP32) |
32ビット浮動小数点 行列積 |
TFLOPS |
従来の汎用計算・グラフィックス演算 |
| Tensor Core (TF32) |
TensorFloat-32(PyTorch TF32有効化) |
TFLOPS |
Ampere世代以降のDeep Learning学習 |
| Tensor Core (FP16) |
16ビット半精度 浮動小数点行列積 |
TFLOPS |
AIモデルの高速学習・推論 |
| Tensor Core (INT8) |
8ビット整数行列積( |
TOPS |
量子化AIモデルのエッジ・高速推論 |
| VRAM Bandwidth |
要素ごとの加算処理( |
GB/s |
VRAM(GPUメモリ)の転送帯域幅 |
主要コンポーネント
-
VMLManager/NVMLMonitor: プロセス全体のNVML初期化・破棄を安全に管理し、別スレッドで0.2秒間隔で温度と電力を取得 -
measure_gpu_time_duration(): テスト関数を受け取り、ウォームアップ後に最適なバッチ数を算出して指定時間ループ実行 -
run_benchmark(): 各行列サイズ(デフォルト: 4096, 8192, 16384)ごとに全テストを実行し、計算結果を表形式で標準出力
<計測手順>
○GPU毎に個別計測を実施。
○GPU1テスト終了後、計測使用率低下を確認し、GPU1を実行。
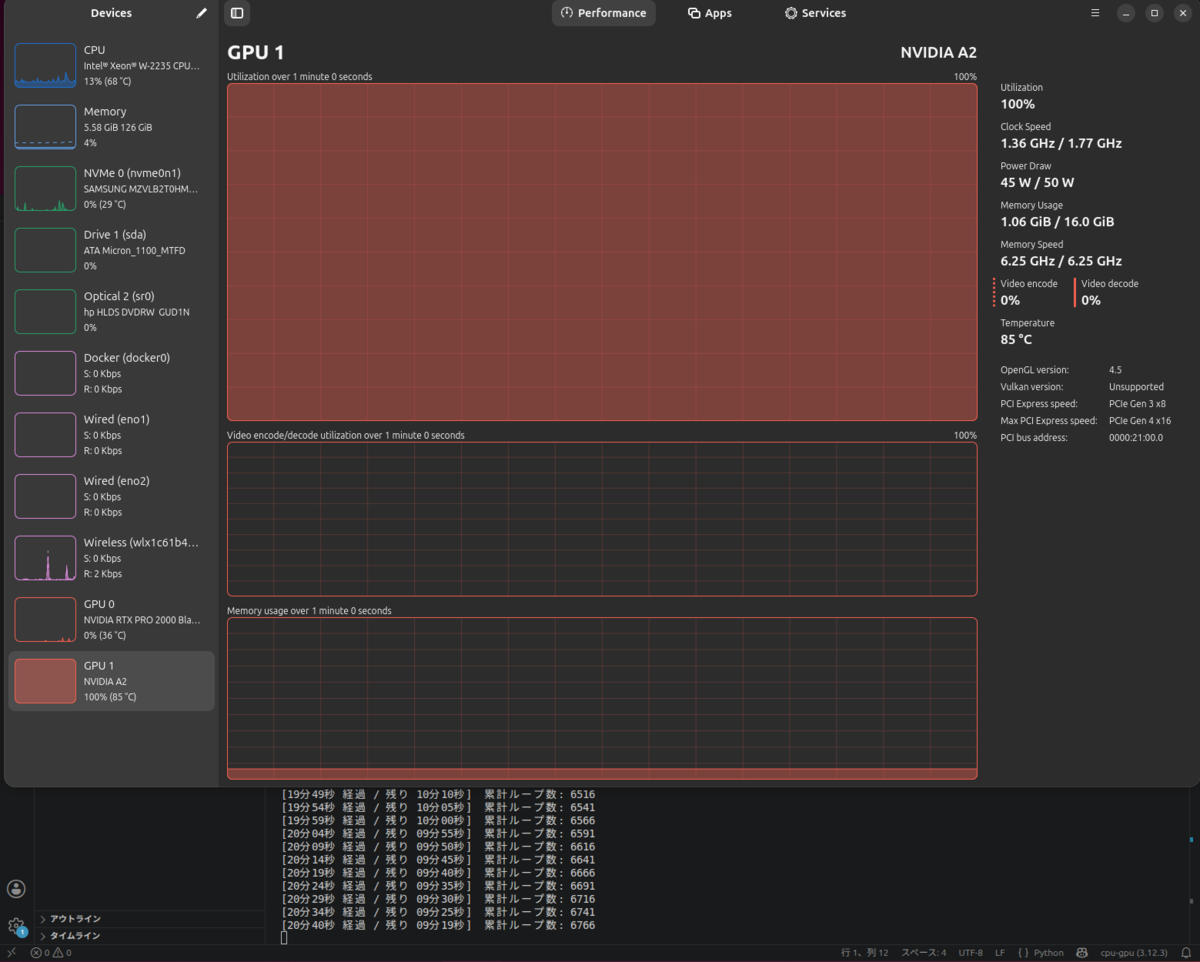
<計算途中>
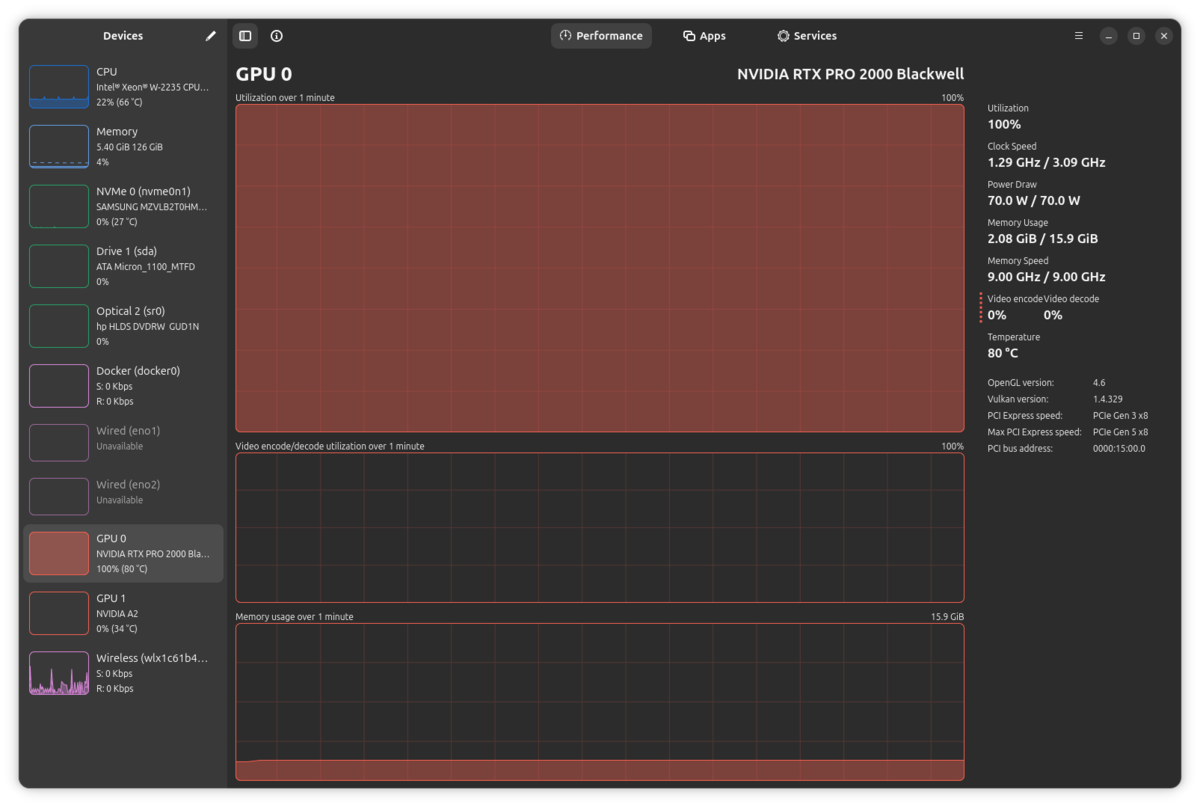
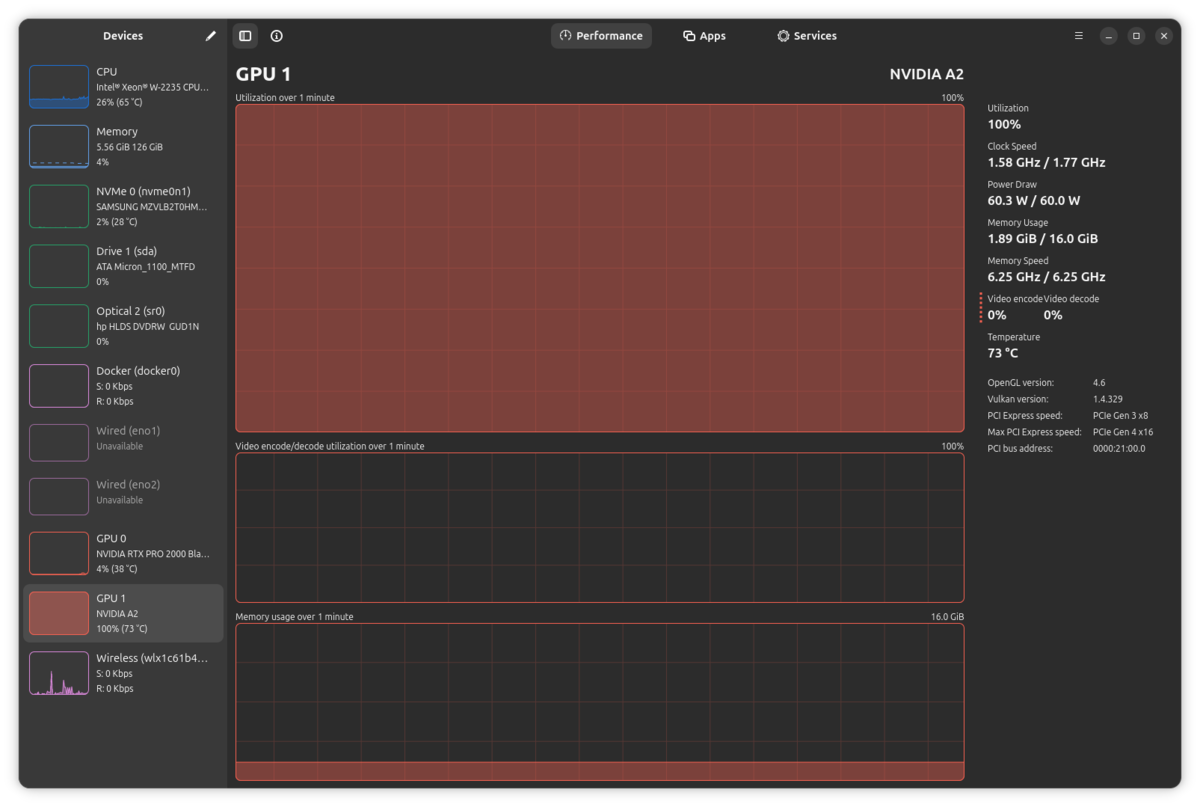
<最後に>
とても面白かった。
同スクリプトがCUDA12.8でも動作したので、Teala P4でも試してみよう。
ぶん回せば、tesla系は計算機として優秀では?と思う。
冷却はめっちゃ重要。
またこんど!